


GRC-платформа операционной готовности розничной сети: кто продолжит продавать, когда откажет облако, поставщик или связь
Непрерывность бизнеса, управление инцидентами, риски поставщиков и внутренний контроль в одном контуре. Карта зависимостей магазинов от ИТ, подрядчиков и цепочек поставок, вычисляемая готовность каждого бизнес-сервиса по RTO, RPO и допустимому простою, регламентные сроки уведомлений и ИИ-агенты, которые обогащают картину данными проверок MD Audit.
Состояние сети: что затронуто прямо сейчас
Управленческий экран: авария в облачной зоне с 03:10, четыре бизнес-объекта из семи задеты, 84 % компонентов под контролем. Карточки сервисов показывают виновника и длительность, а не список серверов. Ниже — главное за период и доля времени без инцидентов.
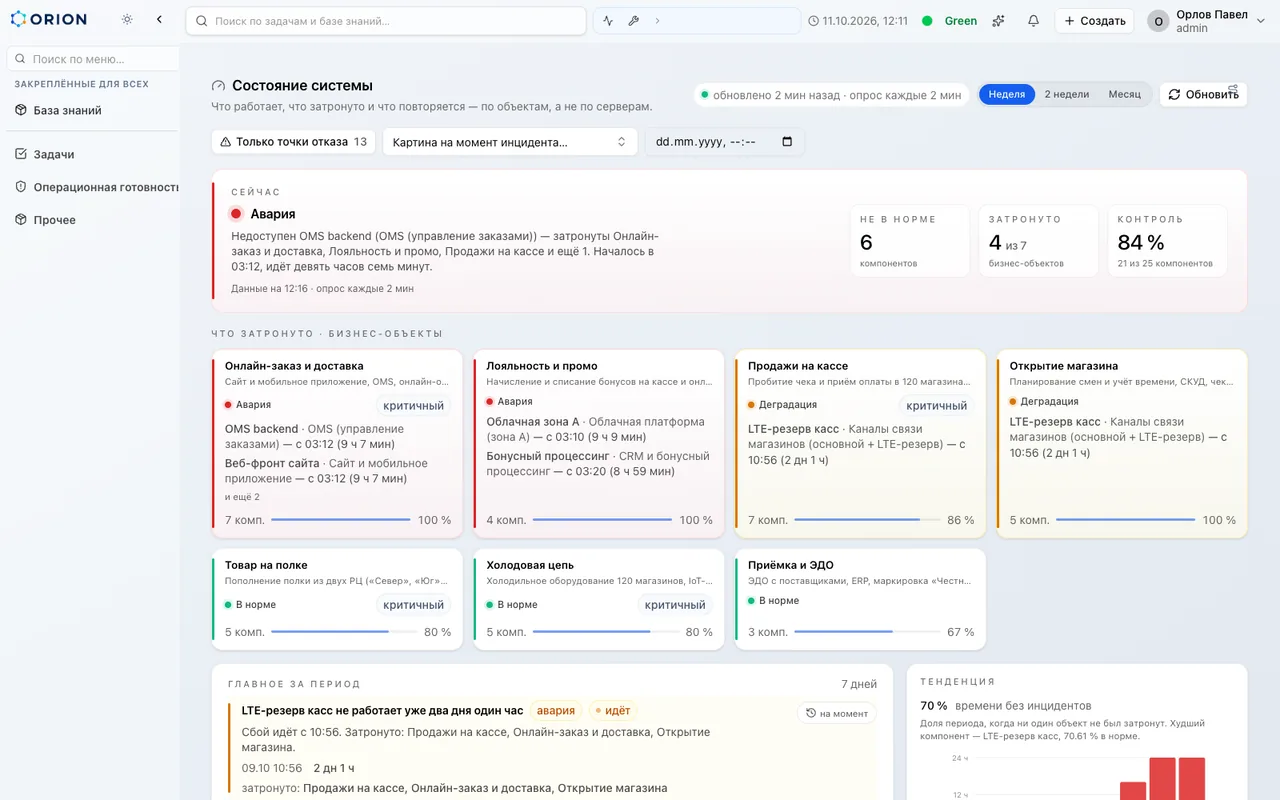
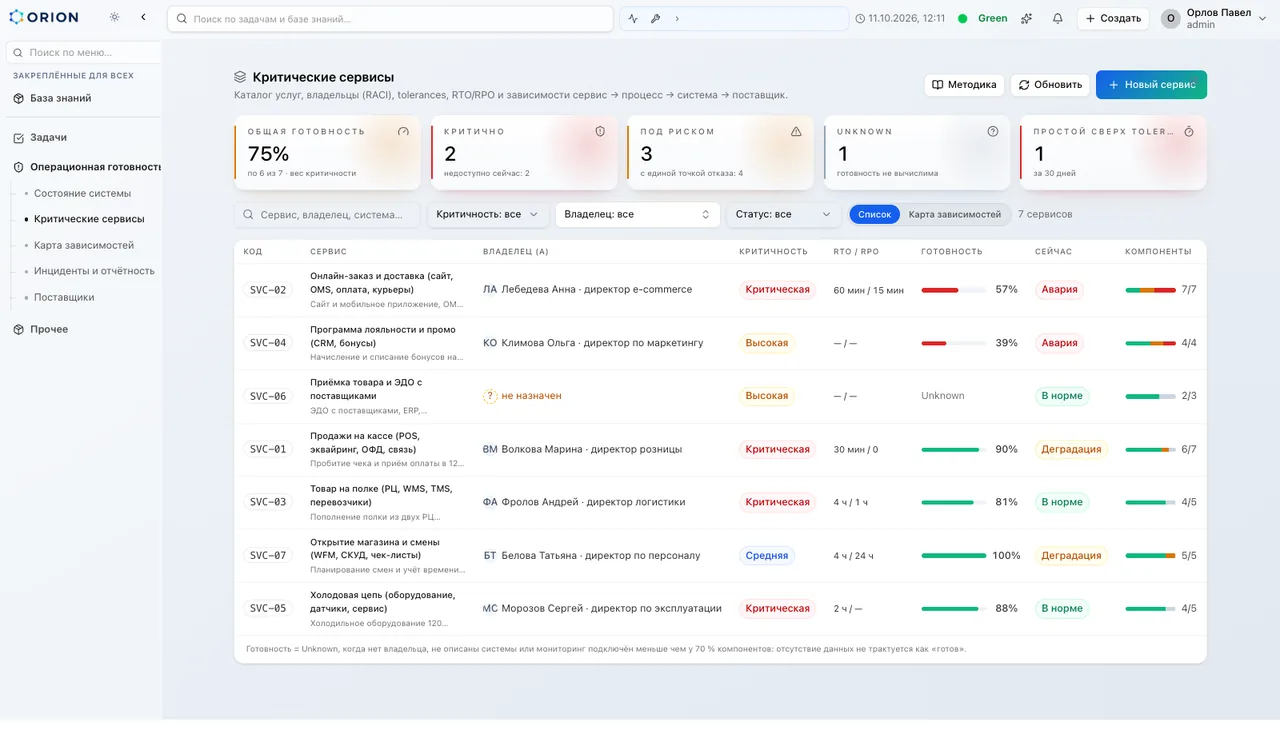
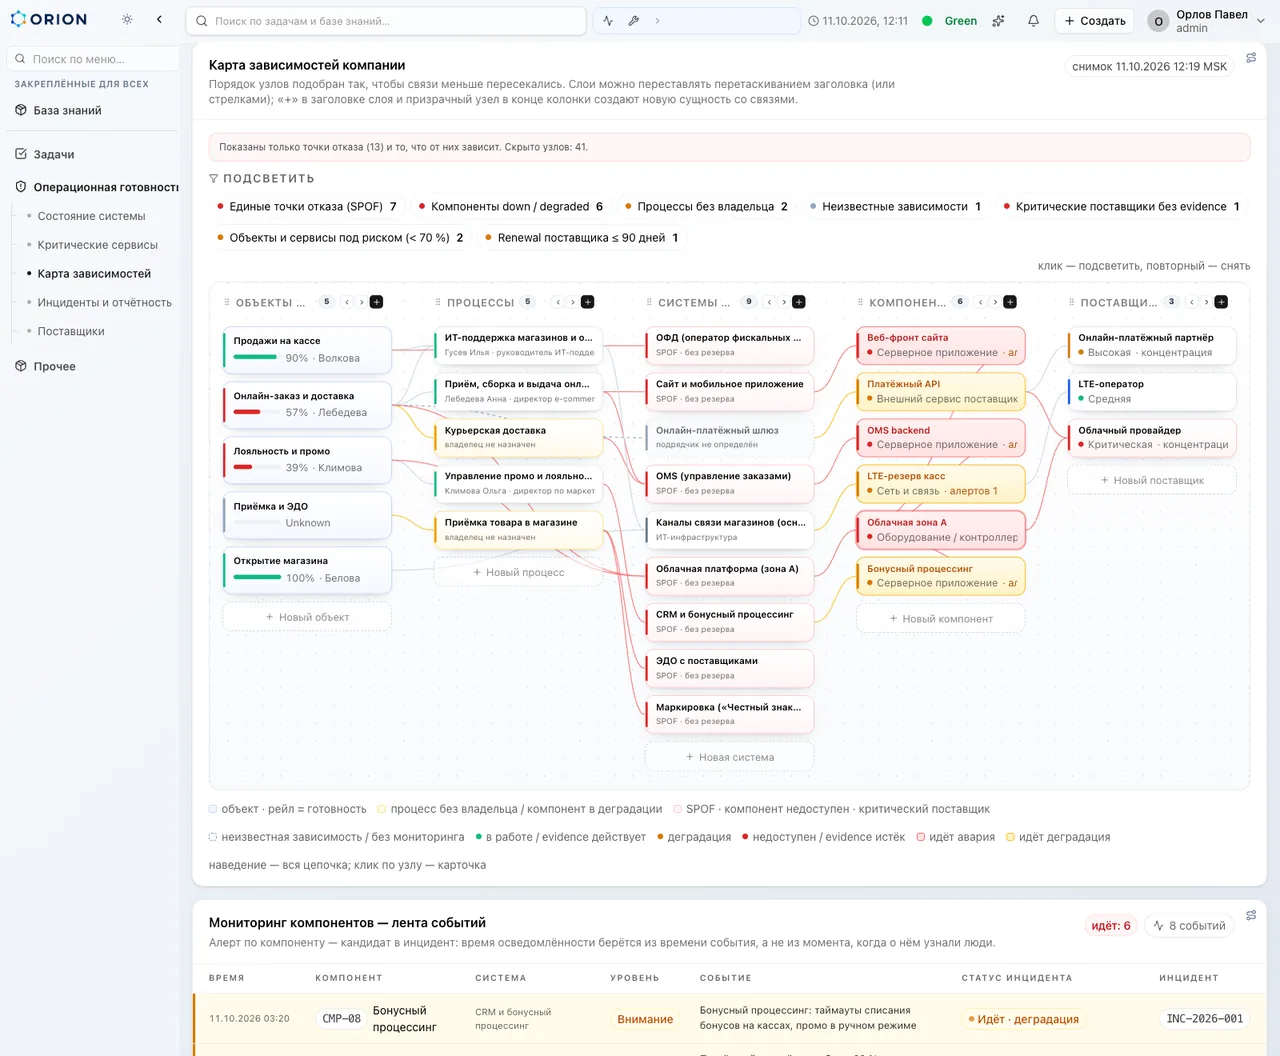
Экраны сняты с модуля «Операционная готовность» MD Audit на демонстрационных данных вымышленной сети «Ритм Ритейл», 120 магазинов. Названия, показатели и события смоделированы.
Что останавливает розничную сеть: угрозы непрерывности бизнеса
Критический сервис в рознице — это возможность пробить чек, пополнить полку, выдать заказ и сохранить товар. Отказ ИТ-сервиса, разрыв цепочки поставок, отказ подрядчика или оборудования — четыре типовых операционных риска, которые система связывает с результатом для покупателя: ИТ, поставщиками, оборудованием и действиями команды в магазинах.
Отказ ИТ-сервиса или облака
Сайт, OMS, лояльность и платёжный шлюз часто живут в одной облачной зоне или у одного провайдера. Одна зона — это один инцидент для всех, кто в ней размещён.
- Что видит система
- Карта показывает общую нижележащую зависимость как единую точку отказа; готовность сервиса падает ещё до инцидента, если резерв не подтверждён.
- Решение
- Проверка переключения на резервную зону и независимость платёжного маршрута — с владельцем и сроком.
Разрыв цепочки поставок
Свежая категория едет одним перевозчиком, ЭДО идёт через одного оператора, этикетки печатает один сервис маркировки. Это концентрация третьего уровня, которую не видно в договорах.
- Что видит система
- Реестр поставщиков с критичностью по факторам, площадкой концентрации и статусом документов. Сервис «Товар на полке» получает статус «под риском» с объяснением.
- Решение
- Резервный перевозчик на категорию и подтверждённый сценарий ручной приёмки — как контроль с датой проверки.
Отказ подрядчика или сервис-провайдера
Касса зависит от эквайринга, ОФД, оператора фискальных данных и сервисной компании по кассам. Каждый — отдельный договор, но для покупателя это один сбой «касса не работает».
- Что видит система
- Сервис «Продажи на кассе» собран из всех своих систем и поставщиков; живой статус приходит из мониторинга и из проверок MD Audit в магазинах.
- Решение
- Runbook переключения на резервный эквайринг и СБП, задания в магазины через MD Audit, подтверждение фото.
Оборудование и холодовая цепь
Отказ оборудования становится инцидентом не ИТ, а операций: списание, санитарные требования, претензии покупателей. Сигнал приходит из чек-листа открытия магазина, а не из мониторинга.
- Что видит система
- Температура из проверки MD Audit — доказательство контроля «Холодовая цепь». Нет свежей проверки — статус «неизвестно», а не «всё хорошо».
- Решение
- Допустимый простой (tolerance), сроки реакции подрядчика в договоре и автоматическая просрочка в инциденте.
Система управления операционной готовностью: от карты зависимостей до подтверждённого восстановления
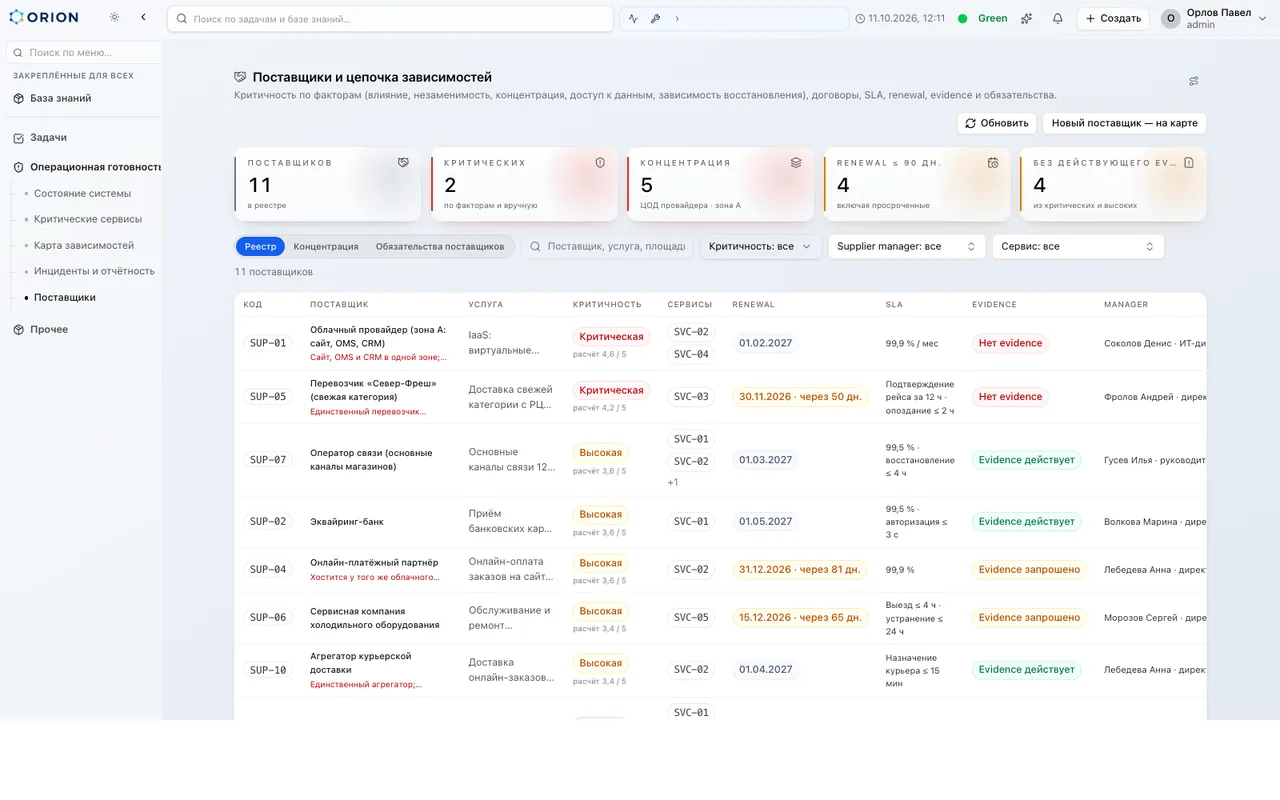
Восемь экранов одного контура, снятые с работающего модуля: состояние сети, каталог критических сервисов, карта зависимостей, реестр поставщиков, система управления инцидентами, эпизоды мониторинга. Каждый статус объясним: нет данных — виден статус «неизвестно» и причина, а не зелёный кружок.
Состояние сети: что затронуто прямо сейчас
Управленческий экран: авария в облачной зоне с 03:10, четыре бизнес-объекта из семи задеты, 84 % компонентов под контролем. Карточки сервисов показывают виновника и длительность, а не список серверов. Ниже — главное за период и доля времени без инцидентов.
Нажмите на экран, чтобы открыть его крупно. Модуль «Операционная готовность», демонстрационный набор розничной сети.
Карта зависимостей и единые точки отказа
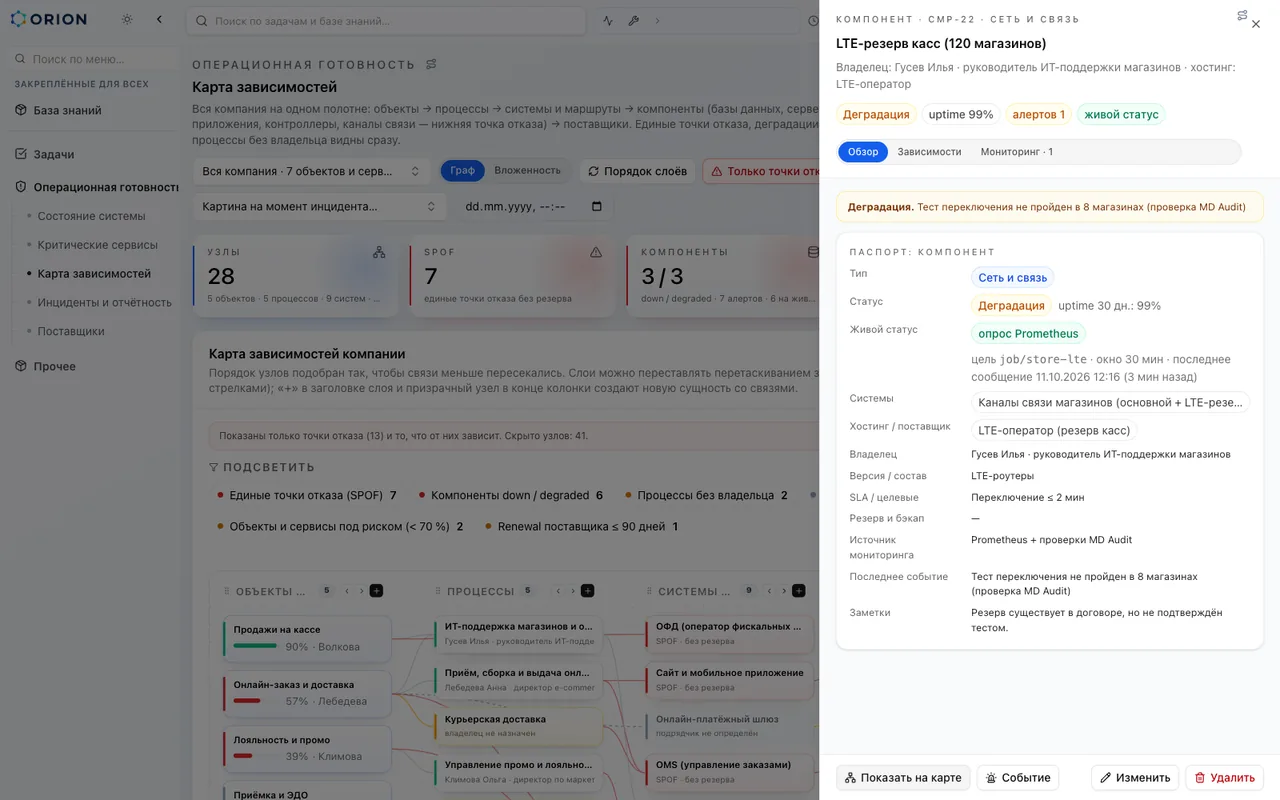
Магазины и сервисы → процессы → системы → компоненты → поставщики. Режимы «граф» и «вложенность», фильтр «только точки отказа»: SPOF, всё, что от них зависит, и их поставщики.
Живой статус: мониторинг ИТ-инфраструктуры
Опрос Prometheus, вебхуки Grafana Alerting и Sentry, собственный формат событий. Молчание мониторинга — отдельный статус: «не наблюдаем» не равно «работает».
Картина «на момент»
Как выглядела сеть в 03:10 ночи, когда начался сбой: статусы узлов и инцидентов восстанавливаются на любую дату и время — для разбора и отчёта.
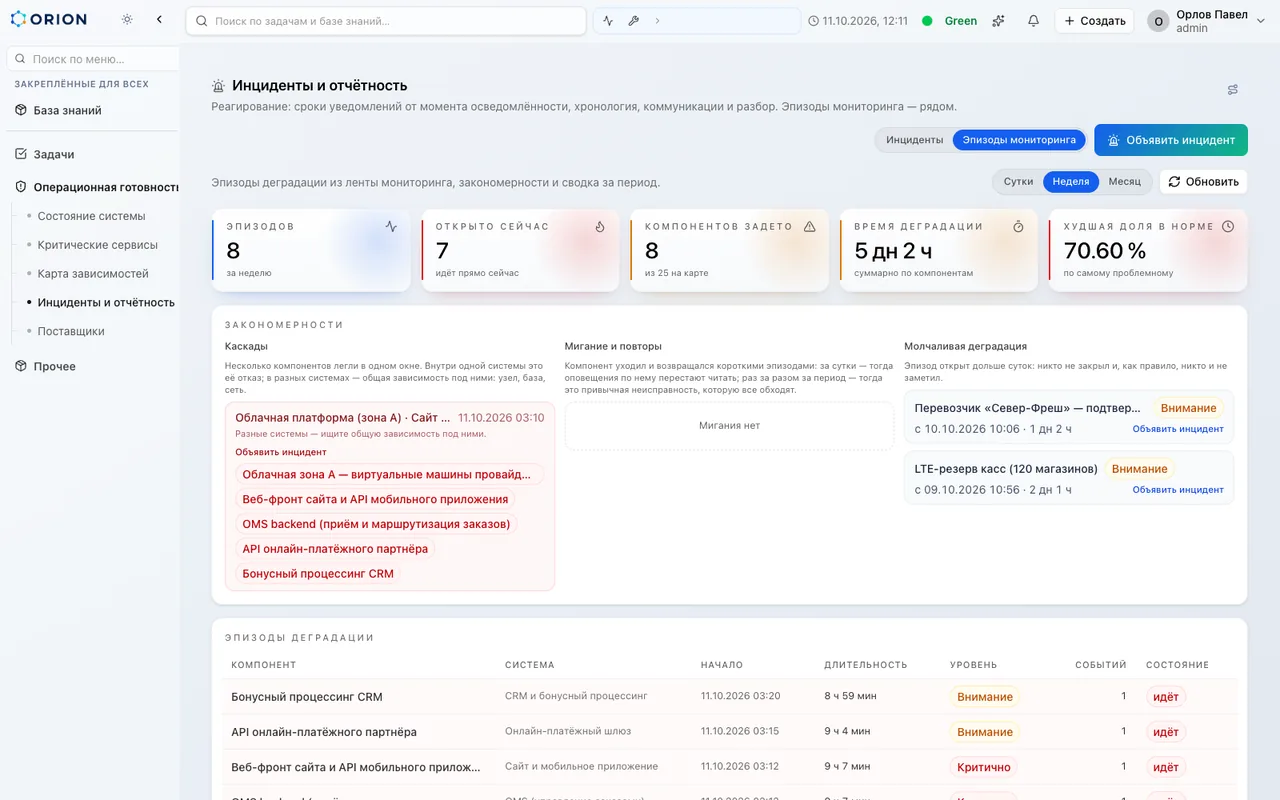
Автожурнал недоступности
Объект уходит в down — запись открывается сама; закрывается только когда виновники восстановлены. Доля времени без инцидентов вместо «средней доступности 99,7 %», прячущей четырёхдневный отказ.
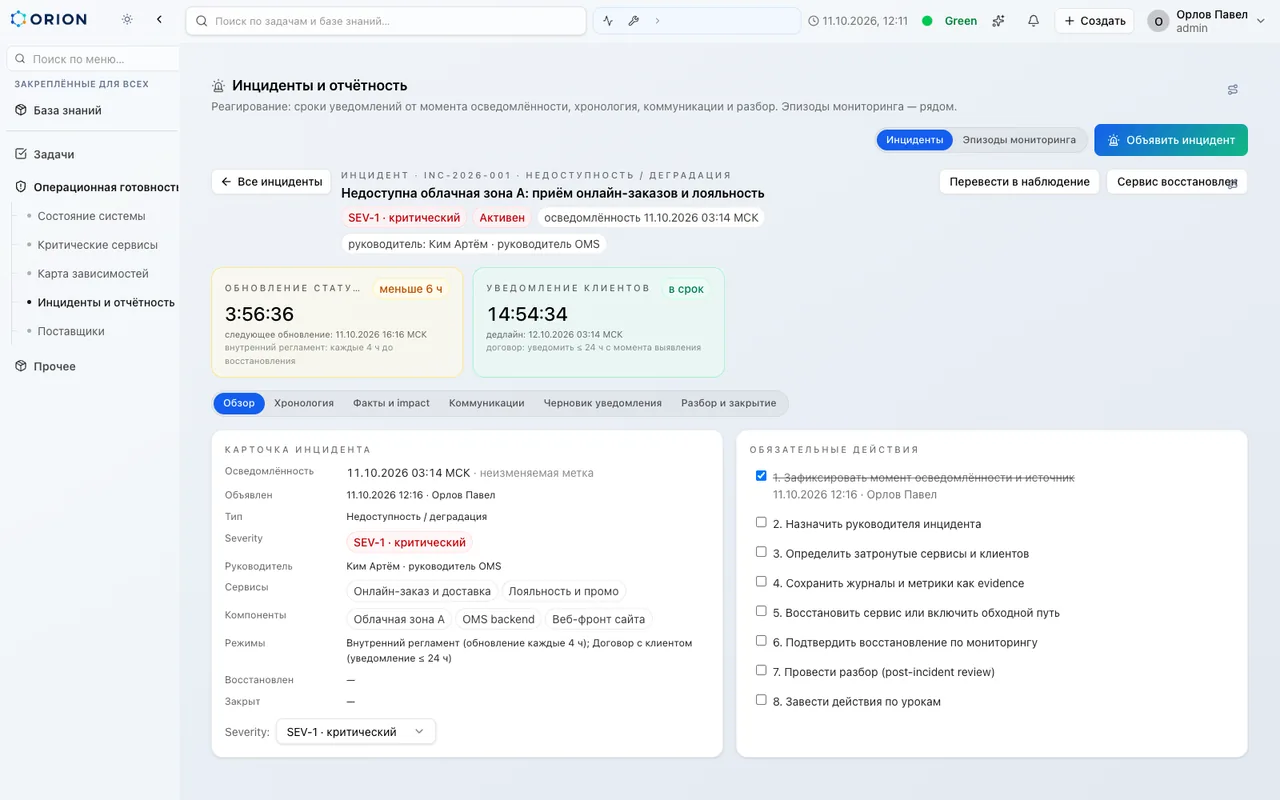
Управление инцидентами с регламентами
Момент выявления неизменяем, записи версионируются, таймеры считаются по регламентам: руководству каждые 4 часа, клиентам до 24 часов, РКН 24/72 часа по 152-ФЗ. Черновик уведомления — только из подтверждённых фактов.
Риски поставщиков и концентрация
Критичность по факторам (заменяемость, доля, срок переключения), документы с датами (evidence), площадка концентрации. Поставщик без свежего evidence снижает готовность зависимых сервисов.
Готовность считается, а не вписывается
Готовность сервиса — не оценка эксперта и не поле формы. Это число из того, что карта действительно знает: кто отвечает, есть ли резерв и единые точки отказа, наблюдаем ли сервис, укладывается ли простой в допустимый (RTO, RPO, tolerance), подтверждены ли критические поставщики. Так анализ влияния на бизнес (BIA) превращается из документа в живой показатель.
| Критерий | Вес | Как оценивается |
|---|---|---|
| Резервирование систем | 30 | Резерв есть — 1, неизвестно — 0,5, единая точка отказа — 0. Среднее по системам сервиса. |
| Наблюдаемость | 20 | Доля компонентов сервиса под живым мониторингом, который не замолчал. |
| Простой в пределах tolerance | 15 | Простой за 30 дней не больше допустимого — 1; сверх — линейно до 0 при двойном превышении. Лимит не задан — 0. |
| Роли и владельцы процессов | 15 | Responsible назначен — 0,4; доля процессов с владельцем — 0,6. |
| Цели восстановления | 10 | RTO, RPO и tolerance заданы — по трети за каждое. |
| Evidence критических поставщиков | 10 | Доля критических и высоких поставщиков с действующим evidence (запрошено — 0,5). |
Готовность начинается с фактов в магазине
Мониторинг ИТ-инфраструктуры видит серверы. MD Audit видит, что происходит на кассе, в холодильной витрине и на приёмке. Система соединяет обе картины в один статус сервиса — так система внутреннего контроля получает доказательства из магазинов, а не из отчётов.
Проверки магазинов становятся доказательствами
Чек-лист открытия, проверка резервного канала связи, температура витрины, приёмка товара, фото и статус задачи. Каждый факт связан с объектом, временем, источником и сроком актуальности — и подтверждает конкретный контроль готовности.
Разрыв возвращается в магазин заданием
Резерв не подтверждён в восьми точках — система формирует задания MD Audit директорам магазинов с критерием приёмки. Повторная проверка закрывает разрыв, а не письмо «всё сделали».
При инциденте runbook уходит в поля
Переключение на резервный эквайринг, ручная приёмка, выдача заказов без OMS — шаги runbook становятся задачами в магазинах, а подтверждение с фото собирается в рабочем пространстве инцидента.
Агенты обогащают картину. Решения принимает человек.
Агенты читают карту, инциденты, историю компонентов, поставщиков и проверки MD Audit через те же инструменты, что и экраны, — и говорят теми же числами. Каждое предложение содержит источники и понятный следующий шаг.
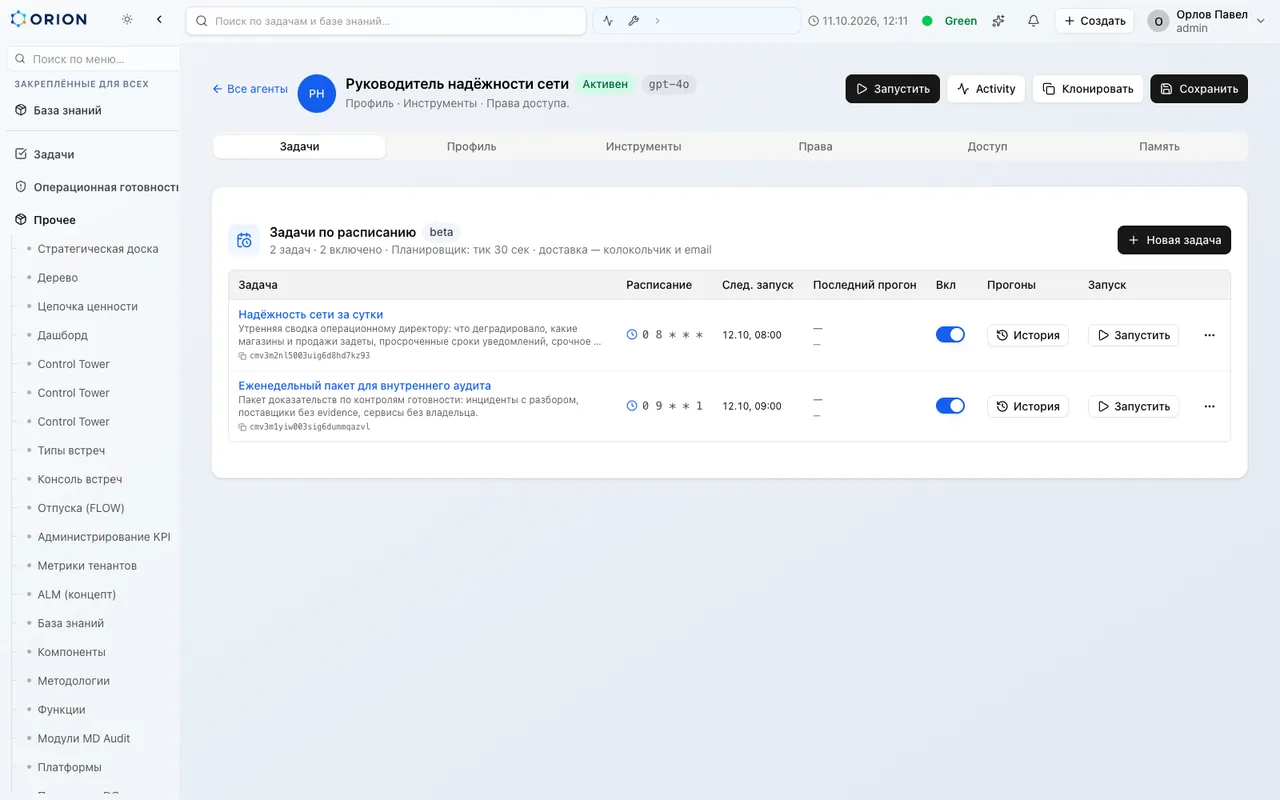
Агент надёжности: отчёт за сутки
Каждое утро читает состояние карты, инциденты, историю компонентов и ошибки, пишет руководству: что деградировало, какие сервисы задеты, где просрочен срок уведомления, у каких поставщиков истекает документ.
Агент обязательств
Извлекает из договоров и регламентов SLA, сроки реакции подрядчиков, требования к резерву и ожидаемые доказательства — и предлагает их как контроли с датой следующей проверки.
Агент зависимостей
Предлагает связи между магазинами, системами и поставщиками по данным ИТ, договорам и базе знаний. Находит общие нижележащие зависимости и помечает гипотезы, требующие подтверждения.
Агент доказательств
Сопоставляет результаты проверок MD Audit с контролями готовности: просроченные проверки, противоречия между магазином и мониторингом, пробелы в данных — в очередь на ревью.
GRC-система в языке, привычном аудиту, рискам и ИБ
Обязательство → риск → контроль → доказательство → решение. Принципы integrated risk management и continuous control monitoring, знакомые по SAP GRC и ServiceNow IRM, применены к тому, что считается результатом в рознице: магазин продаёт, РЦ отгружает, покупатель получает заказ. Для компаний, которые ищут российскую альтернативу SAP GRC, это рабочий контур без миграции методологии.
Анализ влияния на бизнес
Какие магазины, категории и продажи остановит отказ сервиса. Владелец задаёт допустимый простой (tolerance), RTO и RPO — и они входят в расчёт готовности, а не лежат в документе.
- Критичность сервиса: критическая, высокая, средняя
- RACI: Accountable, Responsible, Consulted, Informed
- Приоритет восстановления по весу критичности
Риски поставщиков и концентрации
Заменяемость, доля в категории, срок переключения, площадка. Зависимости третьего и четвёртого уровня — облако под SaaS-провайдером, перевозчик под дистрибьютором — видны на карте.
- Критичность по факторам, override с обязательной причиной
- Документы с датами: действующий, истёк, запрошен
- Концентрация по площадке и провайдеру
Непрерывный мониторинг контролей
Контроль предусмотрен и контроль работает — разные вещи. Доказательство приходит из мониторинга или из проверки в магазине, имеет дату и срок годности.
- Статус «неизвестно», если данных нет
- Просроченная проверка снижает готовность
- Проверки MD Audit как источник evidence
Инциденты и регламентные уведомления
Момент выявления (aware-at) фиксируется и не редактируется; сроки по договорам и 152-ФЗ считаются от него. Срок закрывается только фактом отправки уведомления.
- Руководству каждые 4 часа до восстановления
- Клиентам до 24 часов по договору
- РКН 24 часа и 72 часа при инциденте с ПДн
Разрывы, владельцы, остаточный риск
Каждый разрыв получает владельца, срок и критерий приёмки. Закрытие подтверждается повторной проверкой; принятие остаточного риска — отдельное решение с подписью.
- Очередь решений руководителя
- Исключения с датой пересмотра
- Закрытие инцидента только с разбором причин
Доказательная база для аудита
Журнал событий, версии записей инцидента, кто и когда переопределил критичность поставщика и почему. Отчёт руководству и пакет для внутреннего аудита — из тех же данных, что видят операции.
- Версионность: исправление = новая запись
- Источники ИИ-предложений сохраняются
- Отчёт «на момент» для разбора после сбоя
Магазины, РЦ, ИТ и закупки
Выполняют проверки и корректирующие действия. MD Audit собирает полевые факты и подтверждения, мониторинг — технические.
Операционный контроль и риски
Задают допуски, методики, требования к доказательствам и регламенты уведомлений. Система объединяет картину рисков, разрывов и решений.
Внутренний аудит
Проверяет эффективность контролей и получает пакет принятых доказательств с историей изменений и отчётом «на момент».
Методологические ориентиры: SAP GRC (Risk Management, Process Control), ServiceNow Integrated Risk Management, ISO 22301 и 152-ФЗ в части сроков уведомления. Система не является частью перечисленных решений.
Словарь операционной готовности
Шесть понятий, которыми говорят риски, внутренний контроль и ИТ. Все они — поля в модели, а не разделы документа.
Governance, Risk, Compliance
Единый контур управления, рисков и соответствия: обязательства, риски, контроли, доказательства и решения в одной модели данных. Платформа применяет его к операционной готовности розничной сети.
Управление непрерывностью бизнеса
Business Continuity Management: критические бизнес-сервисы, допустимый простой, план восстановления и проверка, что план работает. В системе — каталог сервисов с вычисляемой готовностью.
Анализ влияния на бизнес
Business Impact Analysis: какие продажи, магазины и процессы остановит отказ сервиса, с какой критичностью и приоритетом восстановления. Задаёт веса в расчёте готовности.
Цели восстановления
Recovery Time Objective — за сколько сервис должен быть восстановлен; Recovery Point Objective — какую потерю данных можно допустить. Вместе с tolerance (допустимый простой за месяц) входят в готовность.
Риски поставщиков
Third-Party Risk Management: критичность поставщика по факторам, концентрация на одной площадке, evidence документов, обязательства по договору и зависимости третьего-четвёртого уровня.
Единая точка отказа
Single Point of Failure: система или компонент без резерва, от которого зависят несколько сервисов. На карте подсвечивается, в готовности снижает балл резервирования до нуля.
Начните с одного критического сервиса
Возьмите зависимость, которая способна остановить сеть: приём оплаты, онлайн-заказ или поставку свежей категории. За 30 дней станет видно, где резерв подтверждён, где он существует только в договоре и какие решения нужны руководителю.
- Диагностика, недели 1–2. Карта сервиса, магазинов, систем и поставщиков; владельцы и допуски; baseline готовности.
- Проверка, неделя 3. Штабное учение по сценарию отказа и согласованные проверки резерва через MD Audit.
- Решение, неделя 4. Реестр разрывов с владельцами и сроками, принятые доказательства, план масштабирования на сеть.
GRC, непрерывность бизнеса, внедрение: отвечаем до пилота
Как сервис получает данные из магазинов?
Через MD Audit: протоколы проверок, ответы на вопросы чек-листов, фото, задачи и их статусы по каждому объекту. На пилоте согласуем состав данных и права чтения. Найденный разрыв возвращается в магазин заданием MD Audit, а результат проверки закрывает его.
Какие ещё источники нужны?
Перечень бизнес-сервисов и их владельцев, зависимости ИТ (можно из CMDB или базы знаний), договоры с критическими поставщиками, мониторинг (Prometheus, Grafana, Zabbix через вебхуки). ERP, WMS, TMS, ITSM подключаются в согласованном объёме. Чего нет — видно как пробел, а не прячется за «зелёным».
Что увидит операционный директор?
Готовность магазинов и критических сервисов, кто сейчас «под риском» и почему, радиус влияния текущего инцидента в магазинах и продажах, очередь решений с владельцами, просроченные регламентные сроки, поставщиков с истекающими документами. Утром — отчёт агента за сутки.
ИИ сам принимает решения при сбое?
Нет. Агенты читают данные через те же инструменты, что и экраны, готовят разбор, черновики уведомлений и предложения связей. Утверждение контроля, принятие риска, переключение процесса и внешние уведомления остаются за уполномоченным человеком, и это записано в журнале.
Что уже работает, а что показано как концепция?
Все экраны на этой странице сняты с работающего модуля: карта зависимостей, живой статус из мониторинга, картина «на момент», автожурнал недоступности, каталог критических сервисов с вычисляемой готовностью, инциденты с регламентами, реестр поставщиков, MCP-инструменты для агентов и задания по расписанию. Данные на экранах — демонстрационная розничная сеть. Связка с MD Audit (проверки как источник статуса и возврат заданий в магазины) и агенты обязательств и доказательств — конфигурация, которую собираем на пилоте под ваши чек-листы.
Чем GRC-платформа MD Audit отличается от SAP GRC и ServiceNow IRM?
SAP GRC и ServiceNow IRM — универсальные GRC-платформы: реестр рисков, контроли, workflow согласований. Платформа берёт ту же модель «обязательство → риск → контроль → доказательство», но считает готовность по живой карте зависимостей и данным из магазинов: статус сервиса меняется от мониторинга и проверок MD Audit, а не от ежеквартальной самооценки. Это российское решение, размещается в облаке MD Audit или в контуре клиента, и не требует миграции методологии — термины BIA, RTO/RPO, TPRM, три линии защиты используются как есть.
Это система управления непрерывностью бизнеса (BCM)?
Да, в части, которую можно проверить данными: критические бизнес-сервисы с владельцами, допустимый простой, RTO и RPO, зависимости до поставщика, единые точки отказа, сценарии отказа и инциденты с регламентными сроками. План непрерывности бизнеса как документ и штабные учения остаются за методологами; платформа показывает, выполняется ли план фактически и чем это подтверждено.
Подходит ли как система внутреннего контроля и комплаенса?
Для операционных контролей — да: контроль «предусмотрен» и контроль «работает» различаются, у каждого доказательства есть дата и срок годности, просроченная проверка снижает готовность, а журнал изменений и версии записей дают пакет для внутреннего аудита. Регламентные сроки уведомлений (договорные SLA, 152-ФЗ) считаются от неизменяемого момента выявления.
Что делать розничной сети при массовом сбое облачного провайдера?
Сначала — знать радиус поражения: какие сервисы и магазины сидят в упавшей зоне и есть ли у них подтверждённый резерв. Фильтр «только точки отказа» показывает это за секунды, картина «на момент» фиксирует, как выглядела сеть в начале сбоя. Дальше — объявить инцидент, перевести приём заказов и оплату на обходные пути, разослать задания в магазины через MD Audit и держать регламент уведомлений руководству и клиентам. После восстановления — разбор с остаточным риском и проверкой резерва.
Где размещается и как с безопасностью?
Облако MD Audit или контур клиента (on-premise уже есть в практике). Доступ по ролям и группам, права на редактирование карты отдельно от просмотра, токены приёма мониторинга хранятся хешами. LLM-провайдер настраивается на тенант; чувствительные инциденты можно закрыть от модели.
Следующий сбой встретит подготовленную сеть
Начните с вопроса: «Если завтра недоступны наше облако, поставщик или связь — чем подтверждено, что магазины продолжат работать?» Ответ должен быть числом с объяснением, а не мнением.
Запросить демонстрацию